

Tình huống
Một nhóm platform đang vận hành cụm EKS production trải dài nhiều namespace. Cảnh báo CPU xuất hiện ngắt quãng nhưng điều tra chậm chạp — kỹ sư phải chạy thủ công các lệnhkubectl qua hàng trăm pod để tương quan log, metrics, và event.
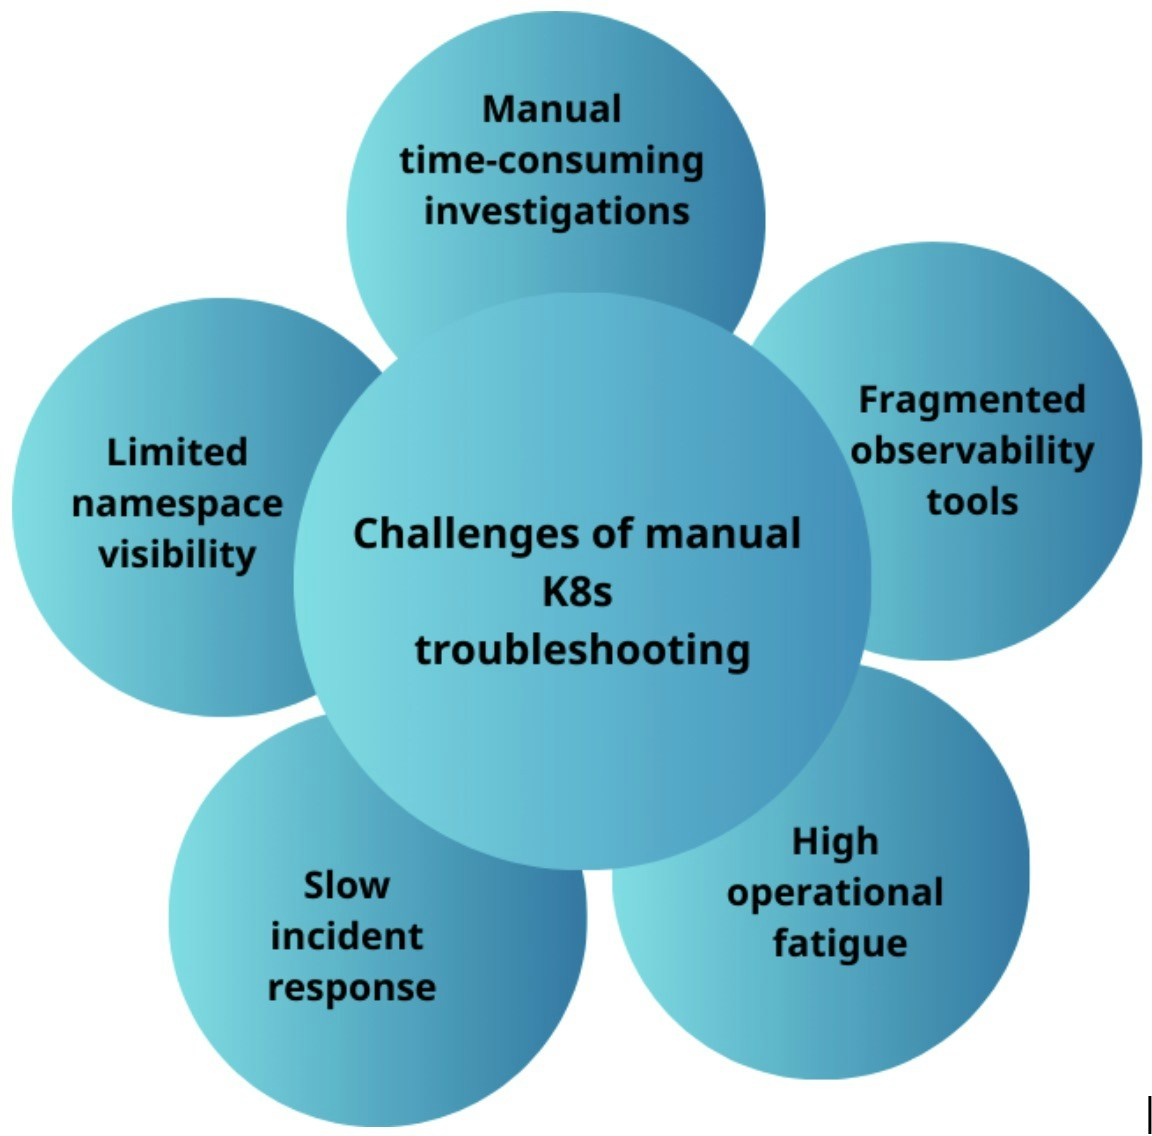
Thách thức khi xử lý sự cố Kubernetes thủ công
Nhóm yêu cầu Kai đánh giá toàn diện cụm, xác định lãng phí tài nguyên, và khuyến nghị chính sách autoscaling cho những nơi còn thiếu.Hướng dẫn từng bước
Điều gì tạo nên hiệu quả
- Kai truy vấn trực tiếp cluster API, thay thế các phiên
kubectlthủ công và chuyển đổi công cụ. - Tương quan đa lớp liên kết mức sử dụng pod, dung lượng node, và mẫu lịch trình trong một lượt phân tích duy nhất.
#reportvà#charttạo đầu ra có cấu trúc để Kai suy luận trước khi trình bày phát hiện.#recommendtạo ra các thay đổi chính sách HPA có thể thực thi thay vì chỉ dump metrics thô.- Tác vụ theo lịch có thể chạy lại phân tích này trước khi kỹ sư trực bị gọi.
Tự mình thử
Tài liệu tham khảo agent Kai
Toàn bộ khả năng của Kai, agent Kỹ sư Kubernetes

Kết nối Kubernetes
Hướng dẫn từng bước kết nối CloudThinker với cụm EKS của bạn
Cụm Pulse
Nhóm các tín hiệu Kubernetes liên quan trước khi chúng trở thành incident
Tác vụ và lịch chạy
Chạy phân tích Kubernetes này theo lịch định kỳ