

シナリオ
あるプラットフォームチームが複数のネームスペースにまたがる本番EKSクラスターを運用しています。CPUアラートは断続的に発生していますが、調査は遅い——エンジニアが何百ものポッドに対して手動でkubectl コマンドを実行し、ログ・メトリクス・イベントを相関させる必要があるからです。
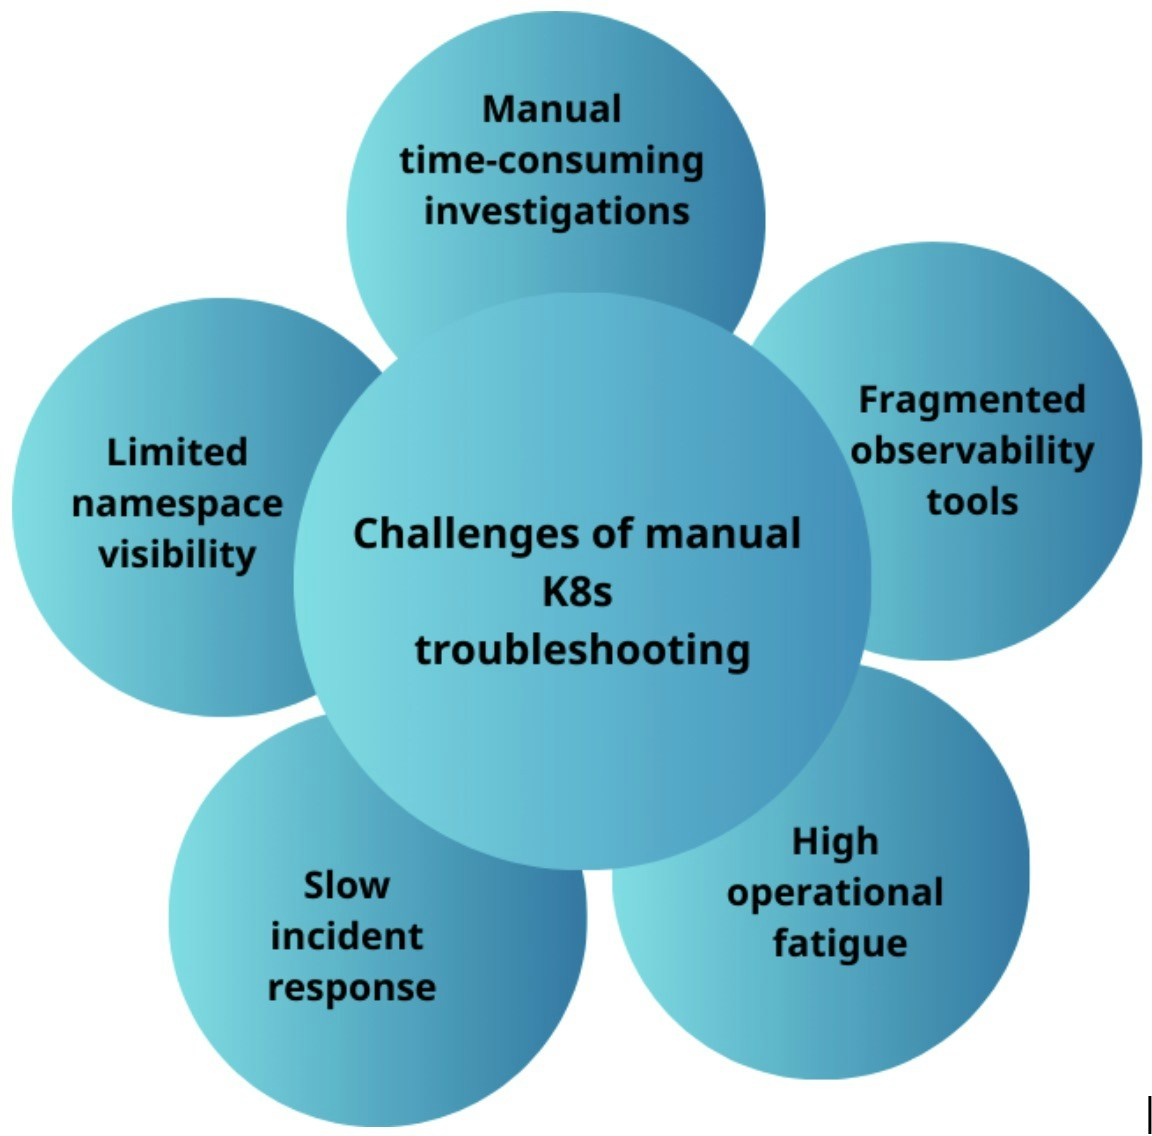
Kubernetesの手動トラブルシューティングの課題
チームはKai にクラスター全体のエンドツーエンドの評価、リソースの無駄の特定、オートスケーリングポリシーが欠けている箇所への推奨を依頼します。ウォークスルー
成果の要因
- Kai がクラスターAPIを直接クエリし、手動の
kubectlセッションとツール切り替えを置き換えます。 - クロスレイヤー相関により、ポッドの使用率・ノードキャパシティ・スケジューリングパターンを単一の分析パスでリンクします。
#reportと#chartが、Kai が知見を表面化する前に推論できる構造化された出力を生成します。#recommendが生のメトリクスダンプではなく、実行可能なHPAポリシー変更を生成します。- スケジュール済みタスク でこの分析を再実行し、オンコール通知の前に問題を確認できます。
試してみる
Kai エージェントリファレンス
KubernetesエンジニアエージェントKai の全機能

Kubernetes接続
CloudThinkerをEKSクラスターに接続するステップバイステップガイド
Pulse クラスター
関連する Kubernetes シグナルをインシデントになる前にまとめる
タスクとスケジュール
この Kubernetes 分析を定期スケジュールで実行する